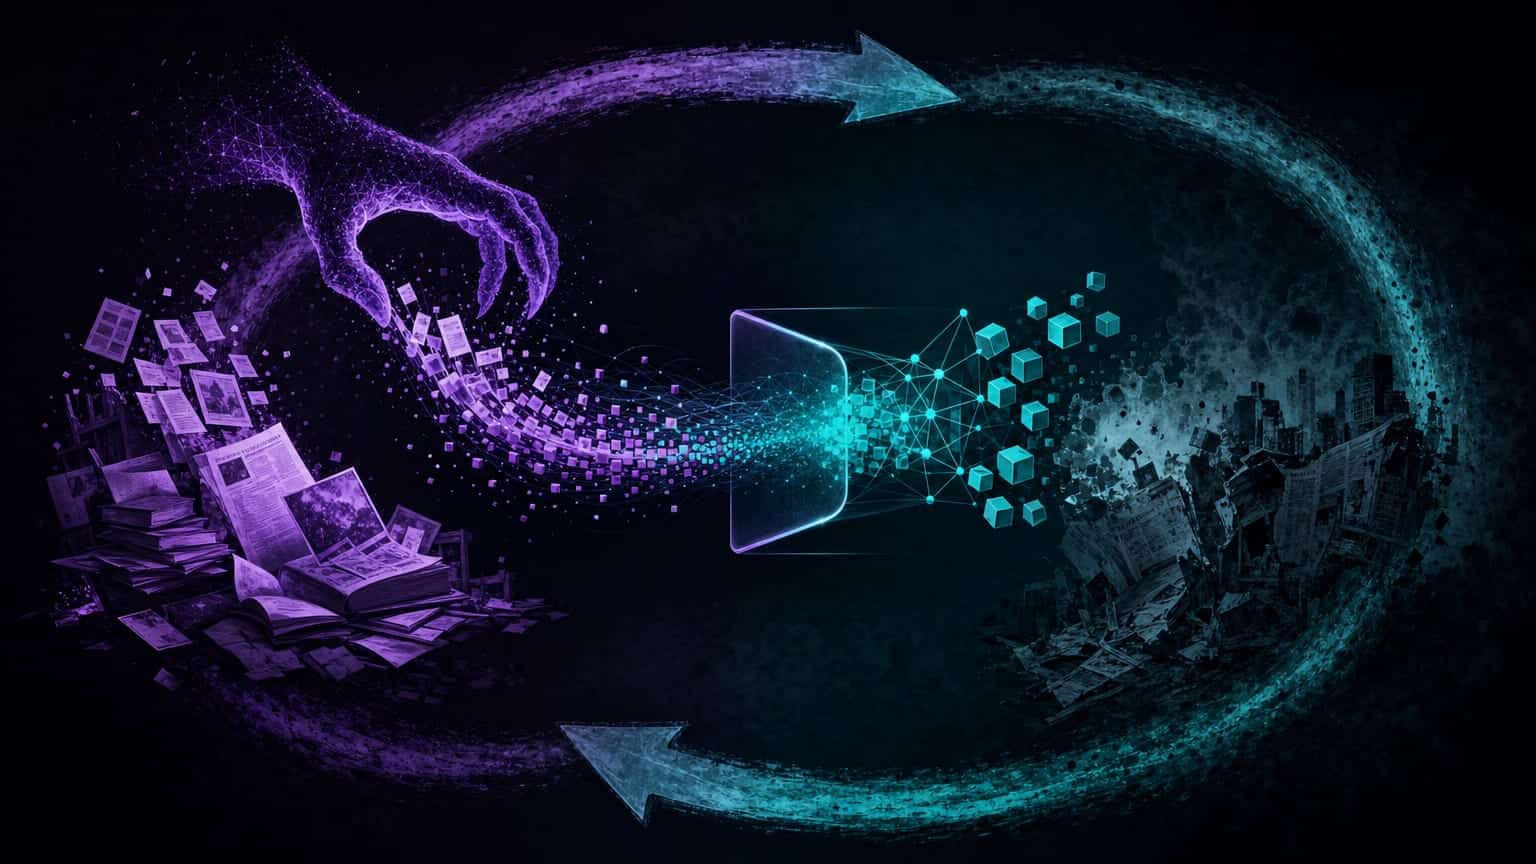
Nově odtajněné dokumenty ze žaloby New York Times ukazují, že Microsoft i OpenAI interně dokumentovaly, že scraping obsahu pro trénink AI způsobí tzv. doom loop pro web, uvádí The Verge ze 18. září 2026. Interní dokumenty popisují efekt jako poškozující pro zpravodajské organizace a web obecně. Manažer Microsoftu scraping označil za největší krádež práce v historii.
Odtajněné soudní spisy z probíhající žaloby New York Times odhalují ostrý rozpor mezi tím, co Microsoft a OpenAI říkaly veřejně, a tím, co si myslely interně. Manažer Microsoftu označil praktiky scrapingu dat pro trénink AI za největší krádež práce v lidské historii – a to v době, kdy obě firmy aktivně stahovaly paywallový obsah NYT a budovaly z něj tréninková data.
Interní e-maily zároveň dokumentují strach z doom loopu: AI nasáváním obsahu oslabuje vydavatele natolik, že nakonec přijde o kvalitní data, ze kterých čerpá. Tento scénář nikdy nezazněl ve veřejné komunikaci firem.
Kauza může zásadně ovlivnit soudní výklad fair use pro trénink AI modelů. Pokud soudy rozhodnou, že interní korespondence dokazuje vědomé porušování práv, mohly by vydavatelé po technologických firmách požadovat retroaktivní licenční poplatky.
Proč by vás to mělo zajímat
Každý, kdo tvoří originální obsah, ať redaktor, bloger, nebo firma publikující odborné texty, sleduje tuto kauzu jako precedens pro budoucí autorská práva. Sledujte průběh žaloby NYT vs. OpenAI – výsledek rozhodne, zda budete moci požadovat odměnu za využití vašeho obsahu při tréninku AI.